发布时间:2026-08-29 11:26:02 来源:转转大师 阅读量:39543
跳过文章,直接图片转WORD在线转换免费>>临时处理、零门槛选在线OCR工具,快速提取截图文字用微信/QQ自带功能,专业文档处理推荐Adobe Acrobat Pro DC,学术论文公式识别用Mathpix,批量处理图片可使用Python脚本。不同方法在识别精度、操作难度和适用场景上各有优势,根据需求选择最合适的方案。
 【官方直达】如果您急需处理文档,可直接点击:图片转WORD在线转换免费入口>>
将图片中的文字、表格等内容转换为可编辑的Word文档,已成为现代办公学习的刚需。无论是扫描件、截图还是手机拍照,都需要快速提取文字。本文从识别精度、操作难度、适用场景三个维度对比五种方法,帮你快速选对方案。
| 方法 | 识别精度 | 操作难度 | 适用场景 | 推荐度 |
|---|---|---|---|---|
| 在线OCR工具(转转大师) | ★★★★☆(较高) | ★☆☆(极简) | 临时处理、清晰图片、不涉密 | ⭐⭐⭐⭐⭐ |
| 微信/QQ自带功能 | ★★★☆☆(中等) | ★☆☆(极简) | 快速提取截图文字、临时应急 | ⭐⭐⭐⭐ |
| Adobe Acrobat Pro DC | ★★★★★(最高) | ★★☆(需安装) | 复杂排版、专业文档处理 | ⭐⭐⭐⭐ |
| Mathpix(公式识别) | ★★★★★(公式99%) | ★★☆(需学习) | 学术论文、复杂公式转换 | ⭐⭐⭐ |
| Python自动化脚本 | ★★★★☆(较高) | ★★★★★(需编程) | 批量处理、古籍数字化 | ⭐⭐⭐ |
快速决策建议:
临时处理、零门槛→在线OCR工具。
快速提取截图文字→微信/QQ自带功能。
专业文档、复杂排版→Adobe Acrobat Pro DC。
学术论文公式识别→Mathpix。
批量处理大量图片→Python自动化脚本。
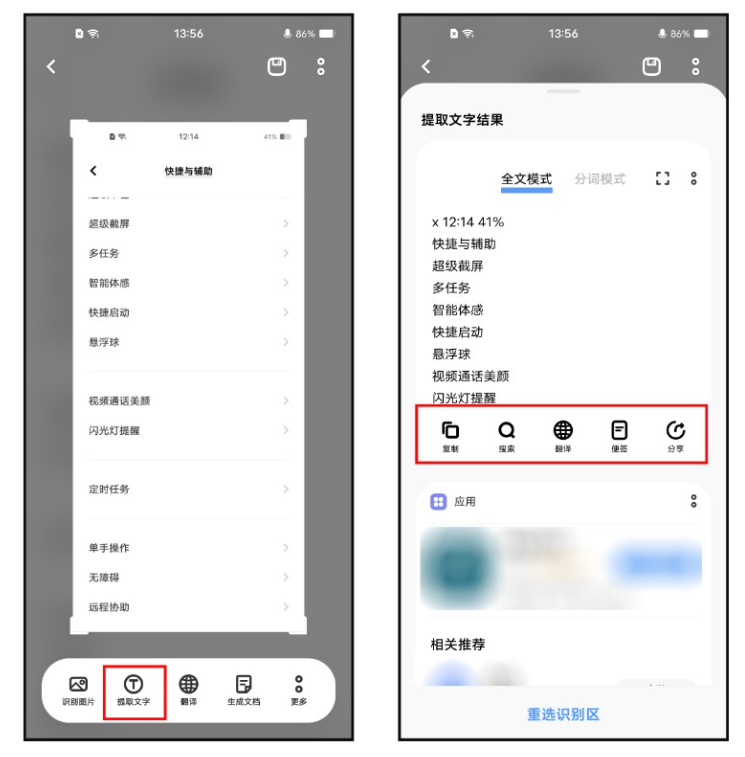
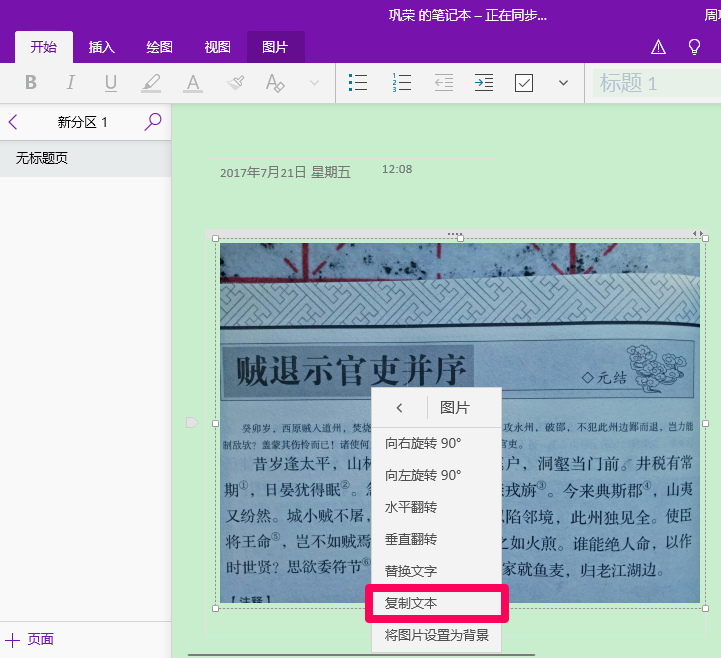
微信和QQ内置了OCR文字识别功能,无需安装任何额外软件。长按图片即可提取文字,PC端QQ截图工具栏也支持文字识别后直接插入Word。适合印刷体中文识别,不支持复杂表格。
操作步骤(手机端):
发送图片到微信/QQ聊天窗口。
长按图片 → 点击「提取文字」。
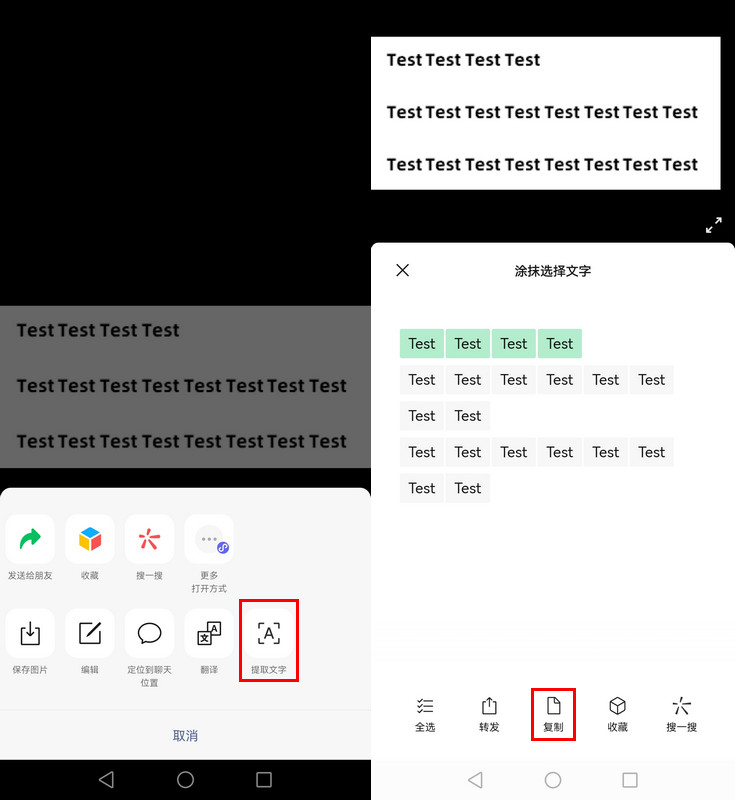
全选复制 → 粘贴到Word文档。
操作步骤(PC端QQ):
使用QQ截图(Ctrl+Alt+A截取图片)。
点击截图工具栏「文字识别」图标。
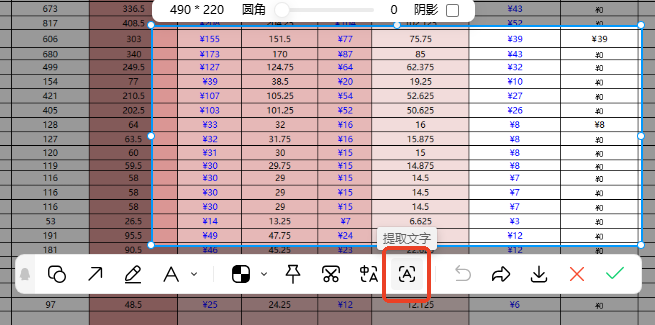
自动识别后可直接插入Word。
注意事项:
⚠️ 识别精度受图片清晰度影响,复杂排版(表格、多栏)无法保留结构。
⚠️ 手写体识别效果差,建议仅用于印刷体文字。
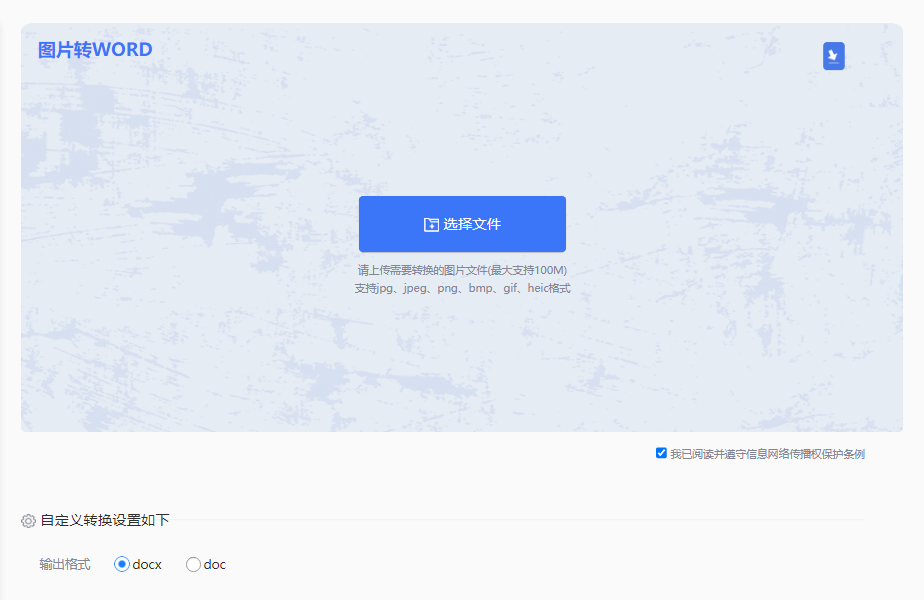
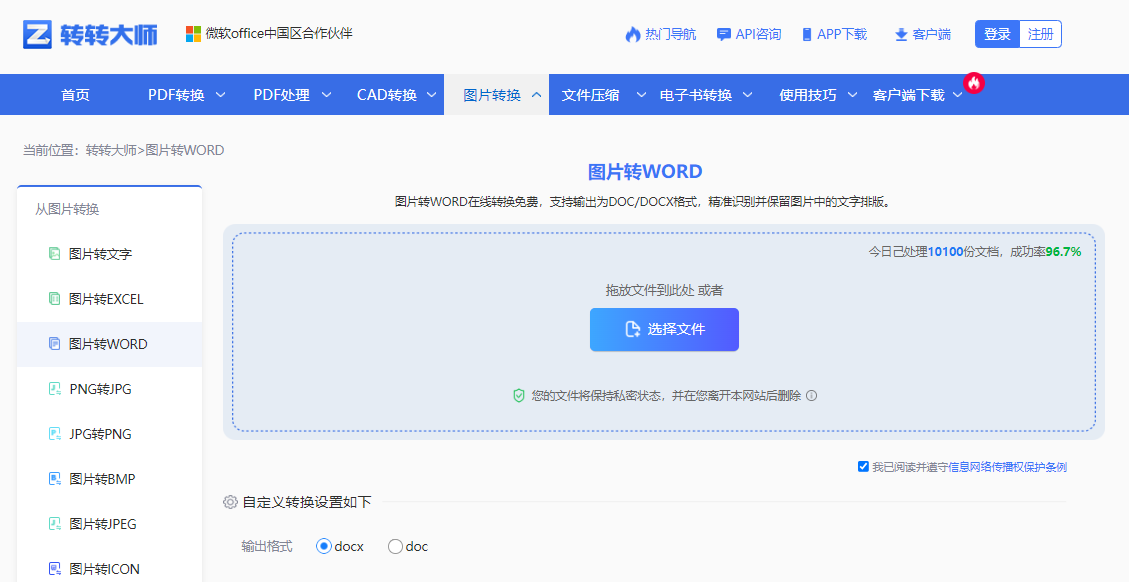
通过浏览器上传图片即可自动识别文字并生成可编辑的Word文档。无需安装,操作简单,支持多种图片格式,适合临时应急处理。
操作步骤:
打开在线图片转word链接:https://pdftoword.55.la/img2word/
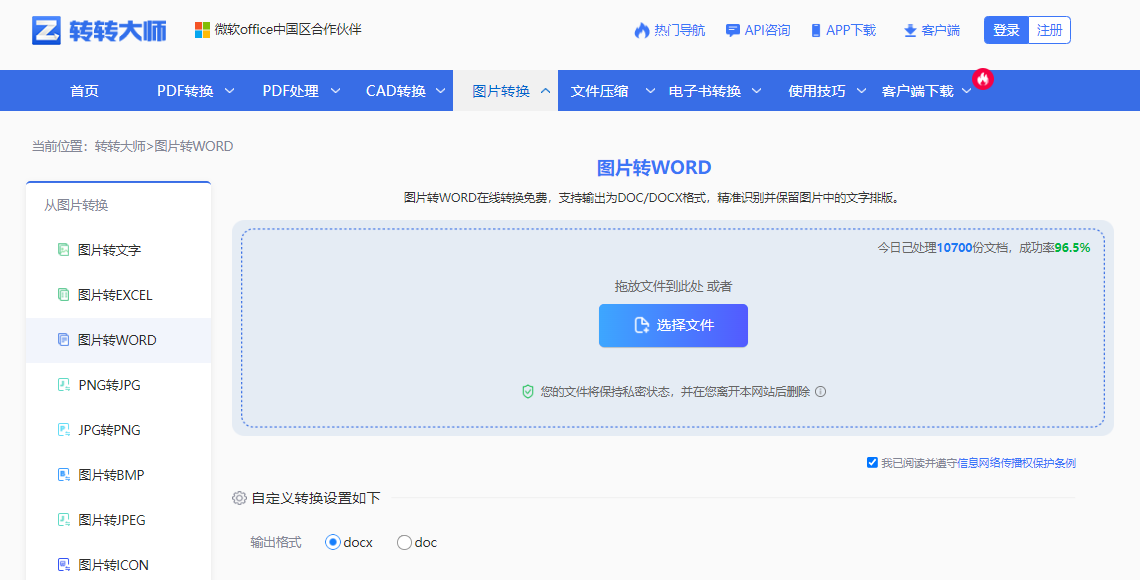
点击“选择文件”,上传需要转换的图片。

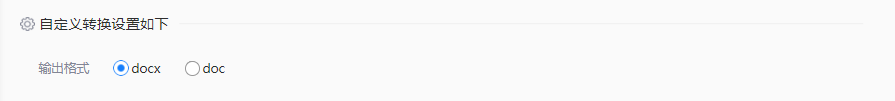
根据需要设置自定义选项(输出格式等)。
点击“开始转换”,等待处理完成。
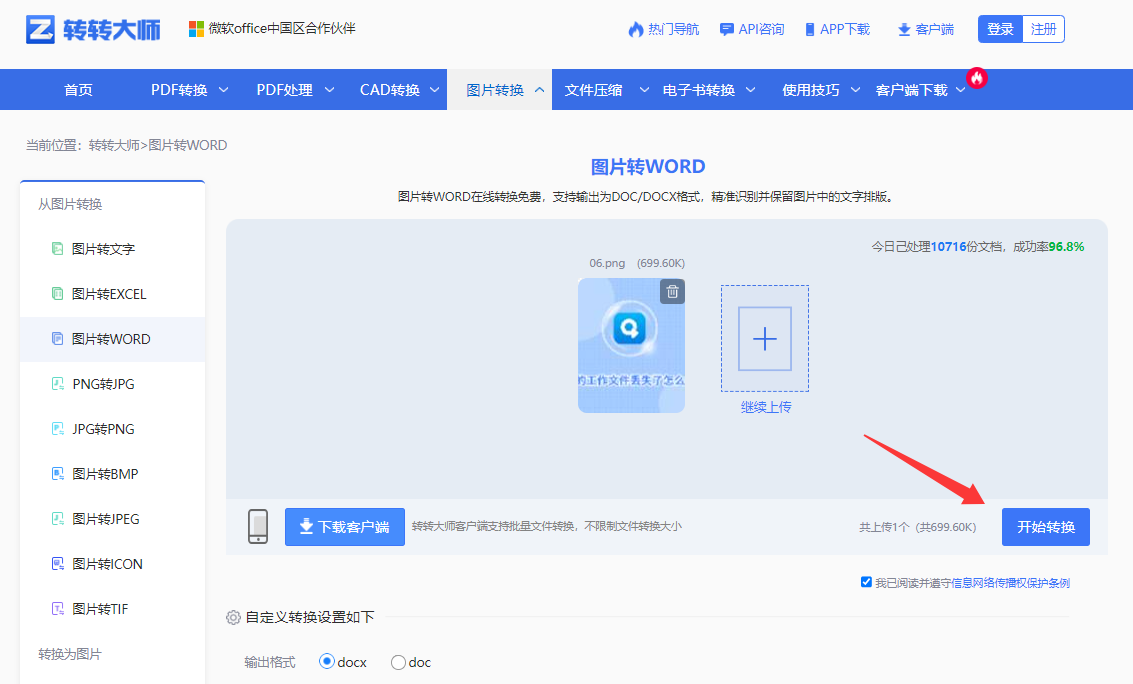
转换完成后,点击“立即下载”获取Word文档。
注意事项:
⚠️涉密图片不要使用在线工具,请改用本地软件。
⚠️ 图片需清晰、文字方向正确(避免倾斜),否则影响识别准确率。
⚠️ 转换后建议逐段校对,修正可能的识别错误。
Adobe Acrobat Pro DC内置专业OCR引擎,可将图片文字高精度导出为Word文档。支持保留页面布局、多语言识别(50+种),自动检测表格并转换为可编辑格式。适合PDF/图片混合处理的专业场景。
操作步骤:
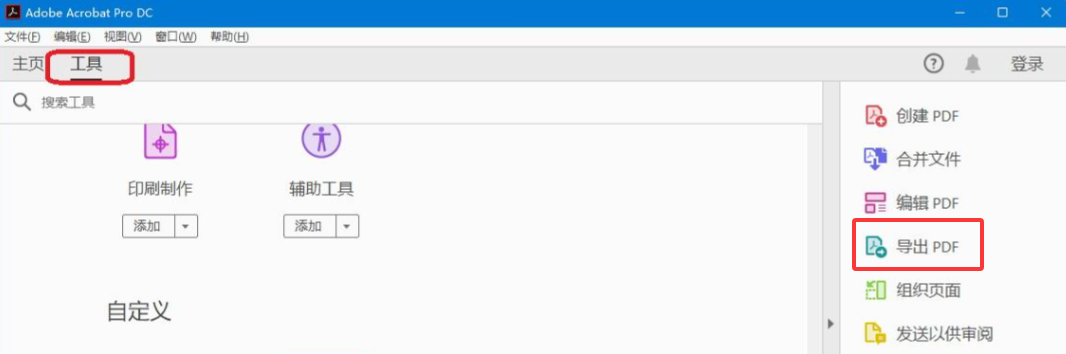
打开Adobe Acrobat Pro DC → 点击「工具」→ 选择「导出PDF」。
拖入图片文件 → 输出格式选「Microsoft Word」。
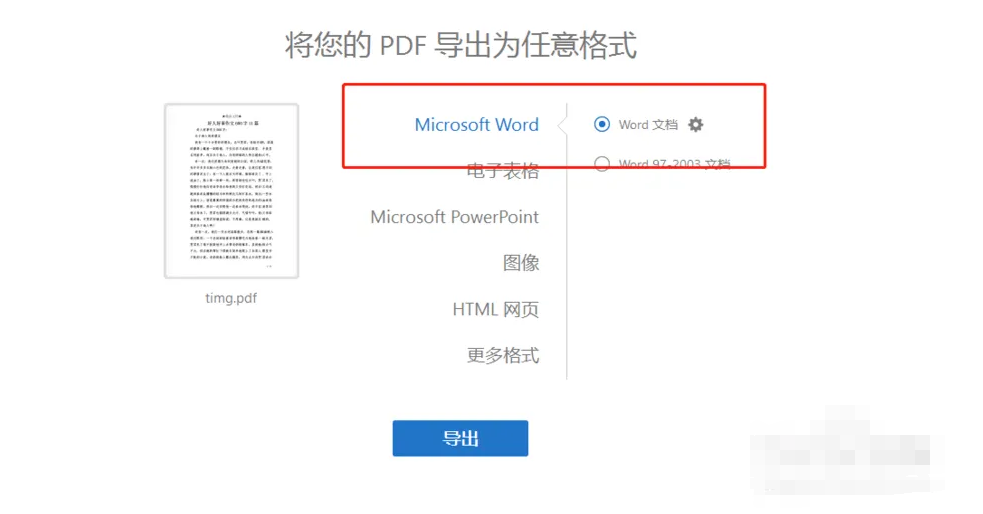
高级设置中勾选「保留页面布局」和「识别多语言」。
点击“导出”,保存Word文档。
注意事项:
⚠️ 需付费订阅,成本较高。
⚠️ 批量处理1000+文件需i5以上CPU+8G内存配置。
⚠️ 试用版导出带水印,长期使用建议购买正版。
Mathpix是全球科研人员广泛使用的公式识别工具,支持将复杂的数学公式截图一键转换为LaTeX或MathML代码,可直接粘贴到Word(需安装LaTeX插件)。简单公式准确率99%,矩阵/积分公式准确率97%,远超普通OCR工具(通常低于10%)。
操作步骤:
下载安装Mathpix客户端(支持Win/Mac/Linux)。
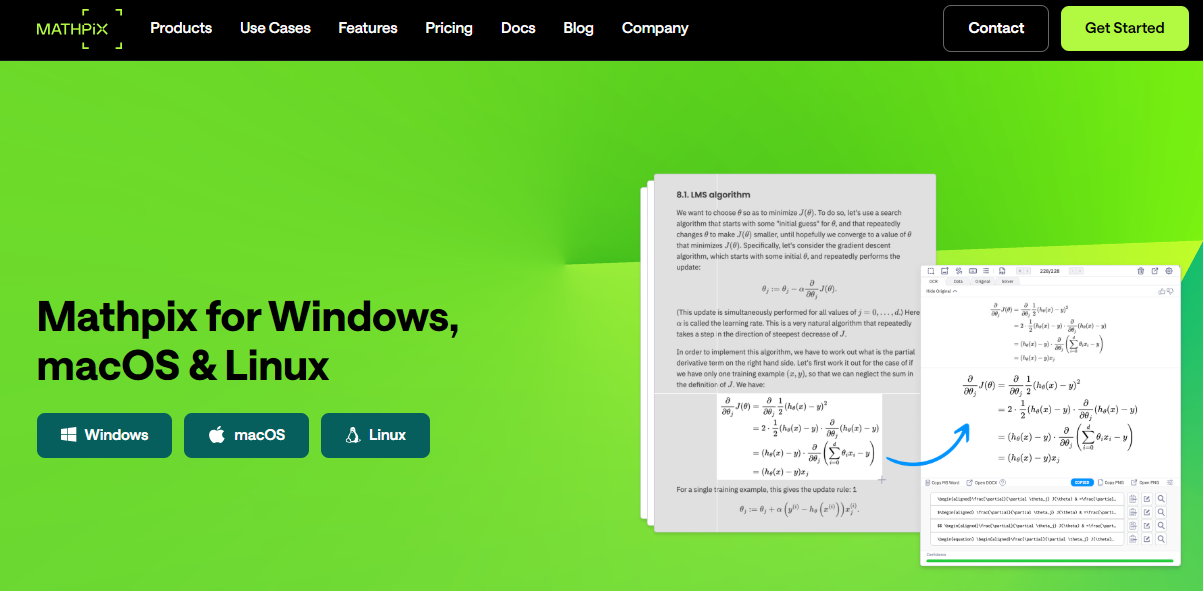
使用快捷键Ctrl+Alt+M框选公式区域。
自动生成LaTeX/MathML代码。
将代码粘贴到Word(需安装LaTeX插件)。
注意事项:
⚠️ 仅适合公式识别,不适合纯文本或表格提取。
⚠️ 免费版每月有使用次数限制,大量使用需付费。
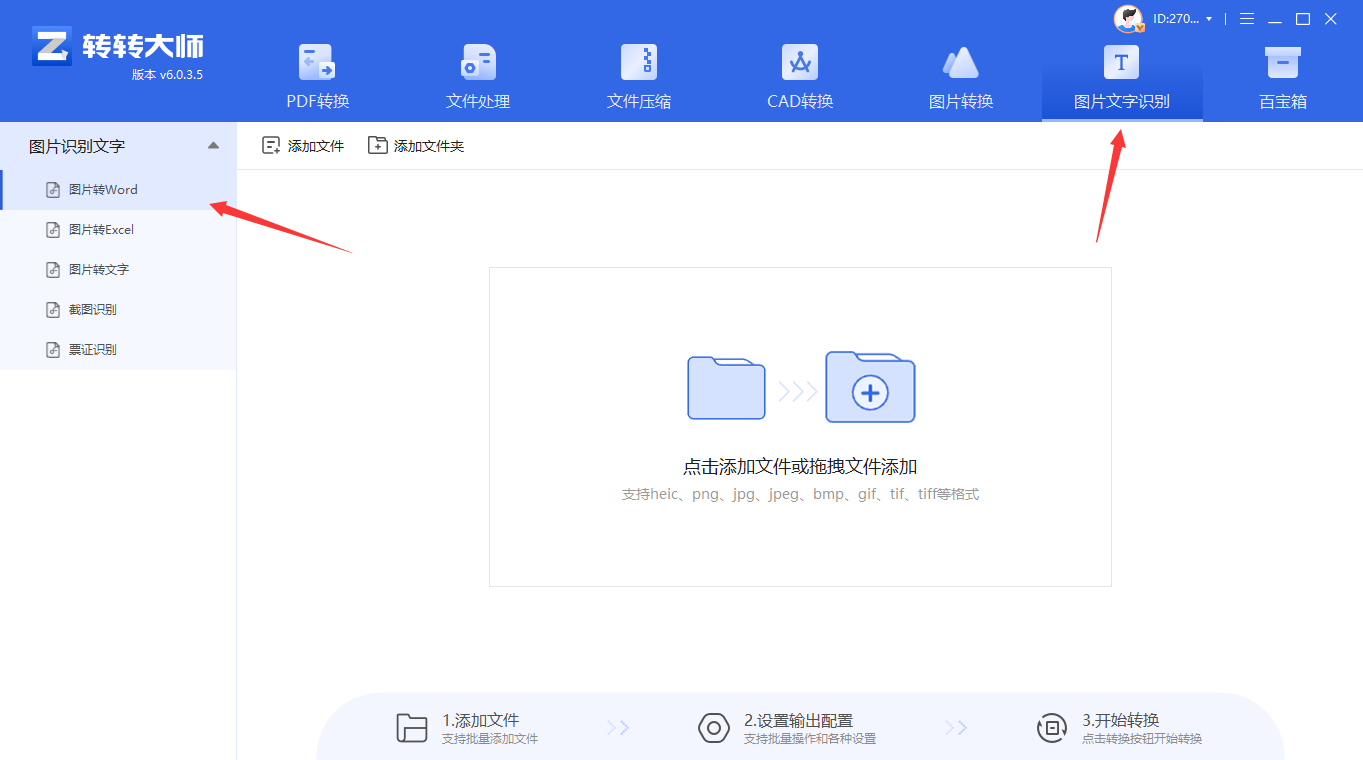
利用Tesseract OCR引擎配合OpenCV图像处理库,编写Python脚本实现批量图片转文字。传统手动录入1小时/页,脚本自动化可达100页/分钟(i7处理器),适合需要大量重复处理的场景。
操作步骤:
安装Tesseract OCR引擎和Python库(pytesseract、opencv-python)。
编写脚本,调用Tesseract识别图片文字。
添加图像预处理(灰度化、二值化、降噪等),提升识别准确率。
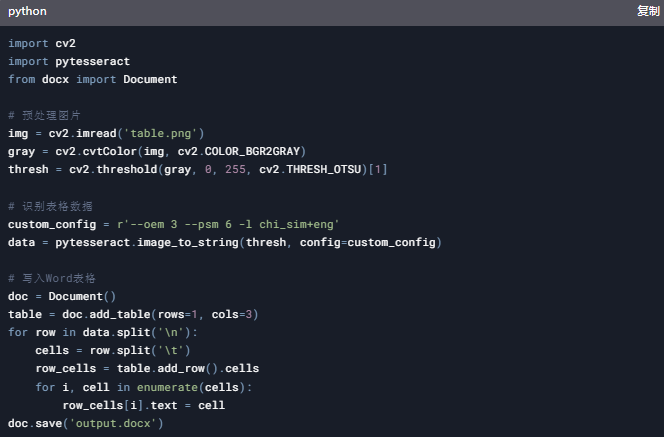
运行脚本,批量处理整个文件夹的图片。
导出识别结果到文本文件或Word文档。
注意事项:
⚠️ 需具备Python编程基础知识。
⚠️ 中文识别需单独下载中文语言包(chi_sim)。
⚠️ 古籍、手写体等特殊场景需额外训练模型。
图片预处理:分辨率建议≥300dpi,优先选择PNG格式(优于JPG),光照均匀避免反光。
识别后校对:OCR识别并非100%准确,转换后务必逐段校对,修正错别字和乱码。
隐私保护:含敏感信息的图片优先使用本地工具(方法三或方法四),避免上传至在线平台。
工具选择:简单公式用普通OCR即可,复杂公式必须使用Mathpix等专用工具。
| 你的情况 | 优先执行方法 | 核心优势 |
|---|---|---|
| 临时处理、零门槛 | 方法一(在线OCR工具) | 即用即走,操作极简 |
| 快速提取截图文字 | 方法二(微信/QQ) | 零安装,秒速完成 |
| 专业文档、复杂排版 | 方法三(Adobe Acrobat) | 精度最高,保留排版 |
| 学术论文公式识别 | 方法四(Mathpix) | 公式识别最强 |
| 批量处理大量图片 | 方法五(Python脚本) | 自动化,效率最高 |
【图片怎么转化为word文档?5种方法对比,按需选择!】相关推荐文章: 返回转转大师首页>>
我们期待您的意见和建议:
 微软office中国区合作伙伴
 热门导航
 API咨询
 APP下载
 客户端
 PDF转WORD
 PDF转图片
 PDF转PPT
 PDF转CAD
 PDF转EXCEL
 PDF转HTML
 PDF转TXT
 OFD转PDF
 图片转PDF
 WORD转PDF
 CAD转PDF
 PPT转PDF
 EXCEL转PDF
 TXT转PDF
 XPS转PDF
 WPS转PDF
 PDF转换器下载
 PDF压缩
 PDF图片获取
 PDF合并
 PDF拆分
 PDF密码解除
 PDF旋转
 WORD合并
 EXCEL合并
 PPT合并
 PDFai阅读
 CAD版本转换
 CAD转DWF
 CAD转图片
 图片转文字
 图片转EXCEL
 图片转WORD
 PNG转JPG
 JPG转PNG
 图片转BMP
 图片转ICON
 图片转TIF
 OFD转图片
 WORD转图片
 PPT转图片
 EXCEL转图片
 GIF转图片
 TIF转图片
 HEIC转图片
 视频压缩
 TIF压缩
 WMF压缩
 JPEG压缩
 证件照压缩
 压缩指定大小
 BMP压缩
 GIF压缩
 PNG压缩
 JPG压缩
 WORD压缩
 PPT压缩
 MOBI转PDF
 EPUB转PDF
 TIF转PDF
 EPUB转TXT
 WORD转TXT
 EXCEL转TXT
 MOBI转TXT
 TXT转MOBI
 AZW3转TXT
 EXCEL转Word
 TXT转Word
 EPUB转Word
 电子书转PDF
 电子书转TXT
 电子书转WORD

 PDF转换器
 OCR文字识别
 数据恢复软件
 PDF阅读器
 PDF编辑器
 微信
 微信
 QQ
 QQ
 QQ空间
 QQ空间
 微博
 微博
 免费下载




 客服热线:17306009113